Несколько человек просили рассказать, как я управляюсь со своими заметками. Там нет ничего сложного или секретного, поэтому решил накидать небольшую статью.
Я всё больше думаю о персональных wiki не как о заметках, а как об инфраструктуре для AI-native работы. И главный вывод, к которому я пришёл, простой: ИИ не нужна «память» в смысле магического долговременного контекста где-то внутри модели. Ему нужна нормальная внешняя среда - wiki, правила работы с ней и слой, который умеет читать, писать и действовать.
Если сжать до одной строки:
Чат - это интерфейс. Wiki - память. Агенты - операторы.
Идея близка к тому, что Karpathy описывал в LLM-вики: вместо того чтобы каждый раз заново гонять поиск по сырому корпусу, знания можно компилировать в связную wiki. Этот принцип работает не только для research. Он отлично ложится на любую персональную работу, обучение, хобби и даже бытовые процессы.
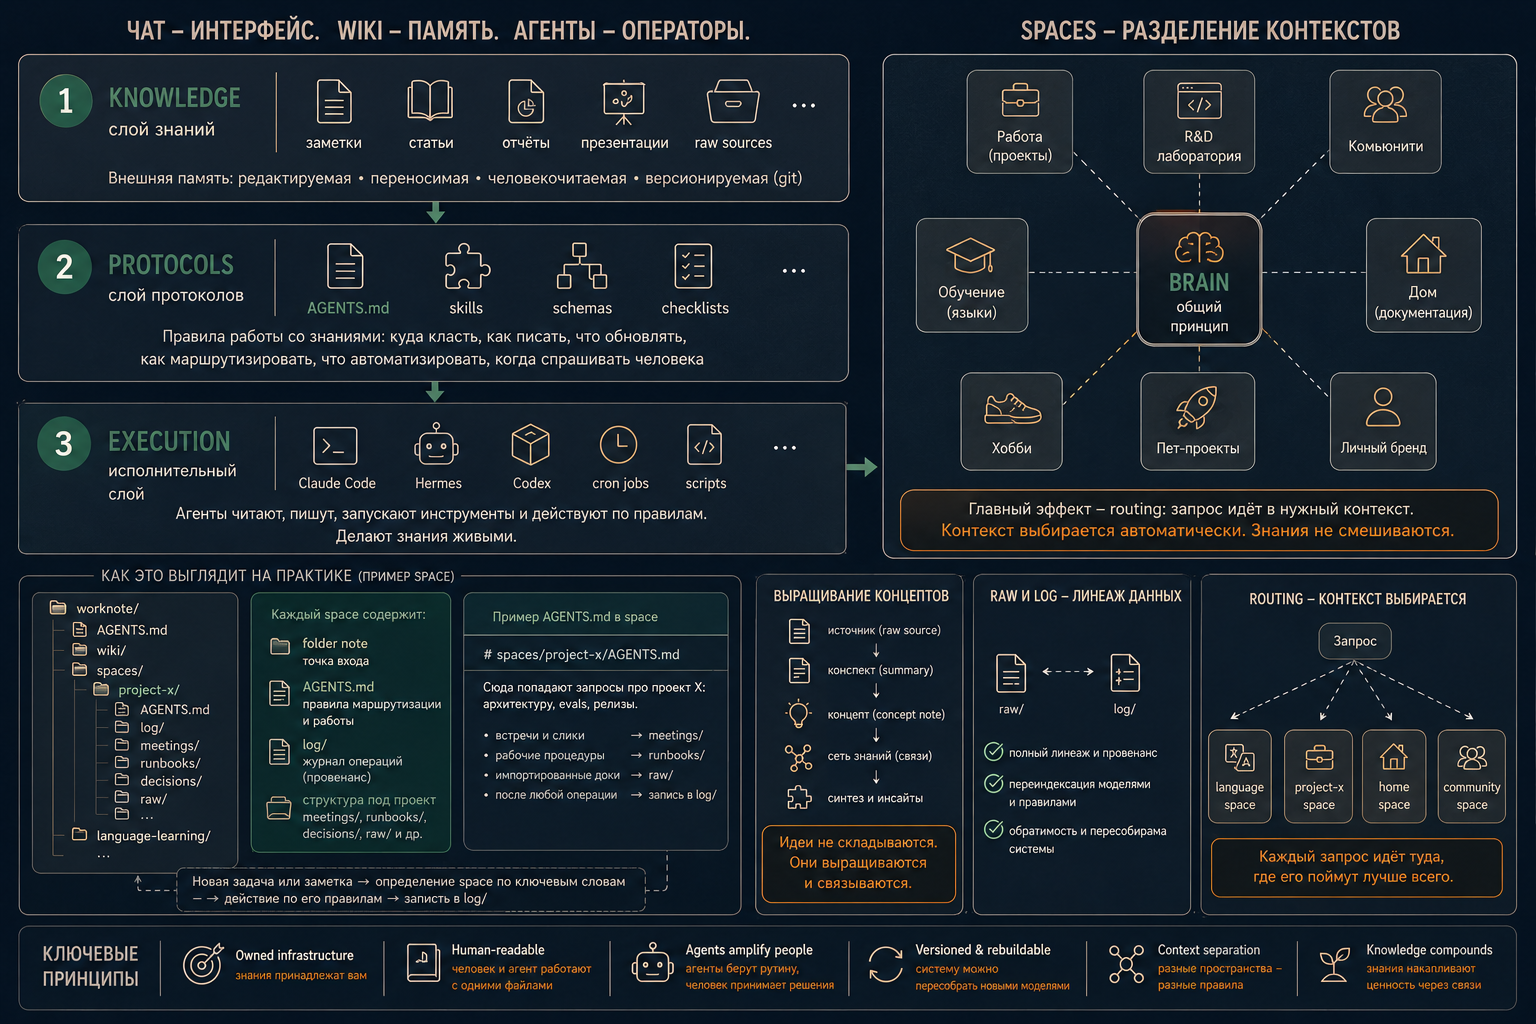
Условно я вижу три слоя:
Knowledge   - markdown, заметки, источники, отчёты, презентации
     ↓
Protocols   - AGENTS.md, CLAUDE.md, schemas, skills, conventions
     ↓
Execution   - Claude Code, Hermes, Codex, cron jobs, scripts
Knowledge - слой знаний
Базовый слой - это сами знания: markdown-файлы, заметки по статьям, отчёты, презентации, summaries, raw sources. Всё, что должно жить дольше одного chat session.
Важно, что это не «память модели». Это внешняя память: редактируемая, переносимая, человекочитаемая. Её может открыть человек в Obsidian или VS Code. Её может читать агент. Её можно версионировать в git и постепенно улучшать.
Тут есть тонкая, но принципиальная разница. Одно дело - «память в продукте», когда модель где-то там что-то запомнила, и ты не контролируешь ни формат, ни срок жизни этих данных. Другое дело - твой собственный слой знаний, который не пропадает при смене модели, провайдера или интерфейса. Это owned infrastructure, а не фича чужого сервиса.
Protocols - слой протоколов
Второй слой - протоколы. Это не сами знания, а правила обращения с ними: AGENTS.md, CLAUDE.md, schemas, skills, conventions. Этот слой объясняет агенту не просто «прочитай файлы», а как именно управляться с заметками. По сути это та же ментальная модель работы с контекстом, которая обычно живёт у меня в голове, только выписанная явно.
Например:
- куда складывать новые источники;
- как писать summary;
- когда создавать новую concept note;
- как обновлять индексы;
- как не плодить дубликаты;
- какие действия можно делать автоматически, а где нужно спросить человека;
- как маршрутизировать запрос между разными spaces.
Это operating manual для работы с контекстом. И он не опциональный: без слоя протоколов wiki быстро превращается в кладбище markdown-файлов. Знания накапливаются, но не становятся системой.
Execution - исполнительный слой
Третий слой - исполнительный. Формально исполнять может и другой человек, но на практике меня интересуют именно ИИ-агенты: Claude Code, Hermes, Codex, cron jobs, custom scripts - любой harness, который умеет читать, писать, запускать инструменты и действовать в рамках правил.
На этом уровне wiki перестаёт быть архивом и становится рабочей системой. Агент может прочитать relevant context, найти связанные заметки, предложить структуру, добавить новую заметку, обновить индекс, собрать draft, проверить противоречия, выполнить рутинную операцию по расписанию.
И вот тут главное. С заметками всегда есть вечный трейдофф: либо ты тратишь кучу времени на организацию, либо потом столько же на поиск. Исполнительный слой снимает этот выбор. Агент берёт на себя кропотливую работу по индексации и связыванию, а ты получаешь быстрый доступ к информации. Именно агенты делают знания живыми.
Но без иллюзий: агентный слой хорош ровно настолько, насколько хорошо ему заданы знания и протоколы. Без первых двух слоёв это просто болтливый исполнитель.
Spaces - разделение контекстов
У меня это уже живёт как набор отдельных spaces. Есть общий brain для статей, идей и evergreen knowledge. Есть отдельные контексты для изучения языка, домашней документации, хобби, пет-проектов и рабочих задач. У каждого пространства свои файлы, свои правила и свой агентный контекст.
Таких пространств у меня уже несколько десятков, и они делятся на группы: рабочие, обучающие, бытовые. Часть из них - персональные, с другими правами доступа, потому что не всё должно лежать в одном общем месте. И это неожиданно хорошо масштабируется: разные контексты, разные правила, разные агенты - один общий принцип.
Главный эффект - routing. Если я спрашиваю про статью, агент идёт в один контекст. Про язык - в другой. Про одежду - в третий. Про домашнюю документацию - в четвёртый. Запросы не падают в один бесконечный чат, где всё смешано в кашу.
Как это выглядит на практике
Чтобы не звучать абстрактно, покажу на примере рабочего пространства. Это не туториал и не полный дамп структуры, скорее иллюстрация принципа.
Мой рабочий brain - это отдельный vault с парой десятков spaces: проект, найм, менторинг, R&D-лаборатория, комьюнити, сертификация, личный бренд, проект x, проект y и так далее. Каждый space устроен по одному шаблону:
- folder note - индекс пространства, точка входа;
CLAUDE.md(или в более общем видеAGENTS.md) - правила маршрутизации: по каким ключевым словам сюда попадает запрос и как тут принято работать;log/- журнал операций для провенанса: что и когда агент сделал.
А дальше жёсткой структуры нет - набор папок складывается под конкретный проект. Где-то нужны meetings/ для встреч, где-то runbooks/ с рабочими процедурами, где-то decisions/ для ключевых решений, wiki/ для синтезированных знаний или raw/ для исходников. Папка появляется тогда, когда под неё реально набирается материал, а не наоборот.
Если совсем по файлам, это выглядит примерно так:
worknote/
├── AGENTS.md                  # общие правила всего vault
├── wiki/                      # знания, общие для всех пространств
└── spaces/
    ├── project-x/             # рабочий проект
    │   ├── project-x.md       # folder note - индекс пространства
    │   ├── CLAUDE.md          # правила маршрутизации и работы
    │   ├── log/               # журнал операций агента
    │   ├── meetings/          # встречи и синки
    │   ├── runbooks/          # рабочие процедуры
    │   └── decisions/         # ключевые решения
    └── language-learning/     # личный контекст
        ├── language-learning.md
        ├── CLAUDE.md
        └── wiki/
А правила, по которым агент работает внутри пространства, лежат рядом - в его CLAUDE.md:
# spaces/project-x/CLAUDE.md

Сюда попадают запросы про проект X: архитектуру, evals, релизы.

- встречи и синки       → meetings/
- рабочие процедуры     → runbooks/
- импортированные доки  → raw/
- после любой операции  → запись в log/
Когда прилетает новая задача или заметка, агент по ключевым словам определяет нужный space и дальше действует по его правилам, а не по общим. Структура одинаковая, наполнение разное. Из-за этого легко добавлять новые пространства: шаблон уже известен и агенту, и мне.
Ещё пример: чтение статей
Внутри brain один из самых частых сценариев - чтение статей. Речь не про любые статьи, а про рабочие и технические. Я не хочу просто сохранять ссылки в read-it-later. Мне важнее, чтобы после чтения оставался reusable knowledge artifact: заметка, summary, ключевые идеи, связи с уже существующими concept pages.
Через время это становится не списком «когда-нибудь прочитать», а картой идей. И агент может не просто найти статью, а помочь собрать synthesis: что я уже читал на эту тему, какие идеи повторяются, где есть противоречия, что можно превратить в пост или проект.
Здесь и проходит граница, которую часто путают:
RAG отвечает на вопросы. Wiki накапливает понимание.
RAG достаёт релевантный кусок по запросу. Wiki со временем превращается в связную картину, которая становится только лучше, чем больше ты в неё вкладываешь.
Raw и log: линеаж данных
Ещё одна привычка, которая окупается: я стараюсь держать полный линеаж данных. У каждой переработанной заметки остаётся сырая исходная версия, а в log/ пишется, что и когда агент с ней сделал.
Зачем. LLM становятся лучше, правила и протоколы тоже улучшаются. И когда это происходит, полезно иметь возможность переиндексировать свой space заново: пройтись новой моделью и новыми правилами по сырым источникам, а не по уже «испорченным» прошлой обработкой summaries. Сырьё плюс журнал операций - это то, что делает всю систему обратимой и пересобираемой.
Масштабирование
Один человек - personal brain. Семья - shared vault. Команда - team wiki. Департамент - сеть wiki и процедур. Компания - corporate brain.
Но чем выше уровень, тем больше проблем, которых почти нет на персональном уровне. Даже семейный vault уже сложнее: несколько пользователей, разные ожидания, разные версии правды. В компании всё ещё тяжелее: access control, ownership, trust, freshness, conflicting knowledge, compliance, incentives, политическая реальность организации. И отдельная боль - обеспечить, чтобы данные не терялись и не возникало разрывов в информации. На масштабе это вручную уже не держится, тут явно нужна автоматизация.
Поэтому я пока не делаю ставку на top-down подход в стиле «давайте сразу построим corporate brain». Слишком много сложности берётся на входе. Да, мы к этому придём, но пока мы не там.
Реалистичный путь сейчас - bottom-up: человек → команда → департамент → компания. Сначала практики обкатываются на уровне отдельного человека, где цикл обратной связи быстрый, а цена ошибки низкая. Потом удачные паттерны переносятся на команду, потом на департамент. И только из этого может вырасти что-то, похожее на настоящий company brain.